项目开源仓库:https://github.com/GuoBug/PatchCat
在线体验地址:https://guobug.github.io/PatchCat/
长文理论原文:《抵抗众数引力:写在自研提示流编排器后的认知重构》(2026-09-16)
前言:为什么将 4000 字深度长文升维为视觉卡片?
在上一篇长文《抵抗众数引力:写在自研提示流编排器后的认知重构》中,我系统复盘了在推进开源提示流编排器 PatchCat 研发过程中,与 AI 结对编程碰撞出的核心系统认知:不主动挂载高维目标标尺,人机协同就会本能地滑向全网统计众数,把最终交付物精准拉向平庸。
很多开发者和产品同行在阅读长文后反馈,这套关于“众数引力、三重锁死飞轮、差分做功、Harness 解耦”的思考模型极具冲击力,但长篇学术化论述对于碎片化移动阅读门槛较高。
为了让这套核心心智模型更具穿透力与传播性,我沿用个人站点的 Neo-Brutalism(新野兽派) 高对比度视觉风格,将整篇论文级的思考浓缩重构为一套 5 张竖屏高密度图文卡片(小红书发布全家桶)。在此同步完整收录至个人数字空间,供大家反复翻阅检索与交流研讨。
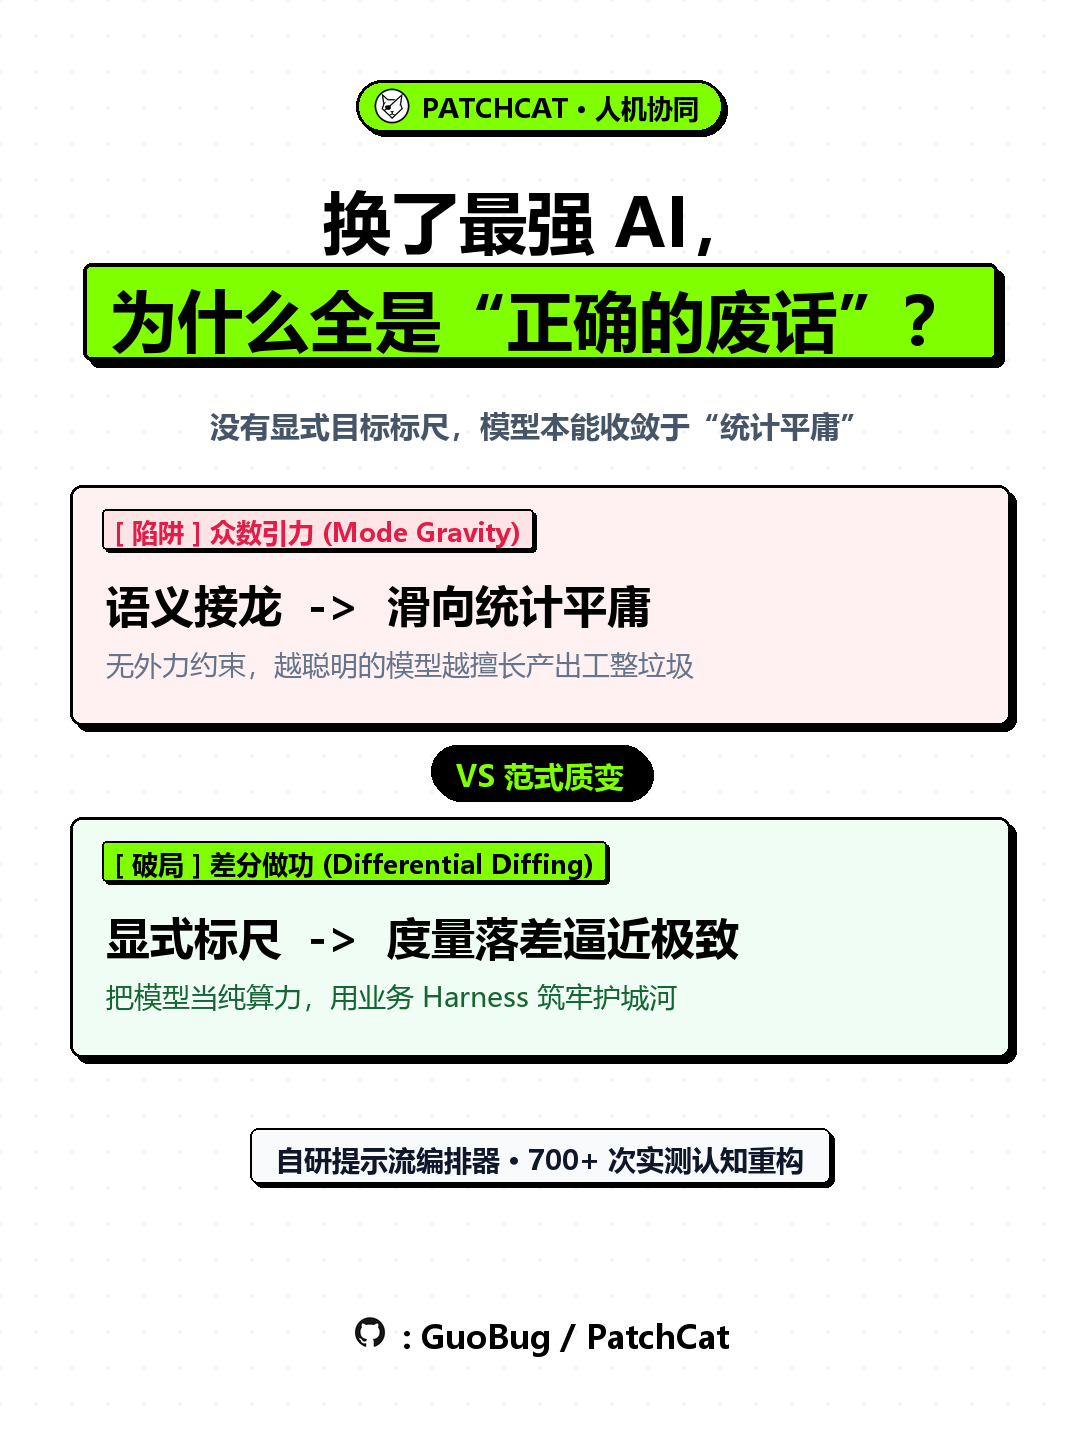
01 / 05 · 破题金钩:为什么换最强大模型,反而产出正确的废话?
💡 核心认知冲击:
- 直觉误区:很多人误以为“只要换上最新最贵的底座模型,代码与架构质量就会自然飞跃”。
- 残酷真相:大语言模型天然在全网语料的条件概率分布上做采样。如果人机交互时没有强行注入高维标尺,系统的最优解必然是“最安全、最通用、也最缺乏穿透力的统计折中”,最终把每一次交付变成毫无灵魂的正确废话。
02 / 05 · 根因剖析:众数引力与三重锁死负向飞轮
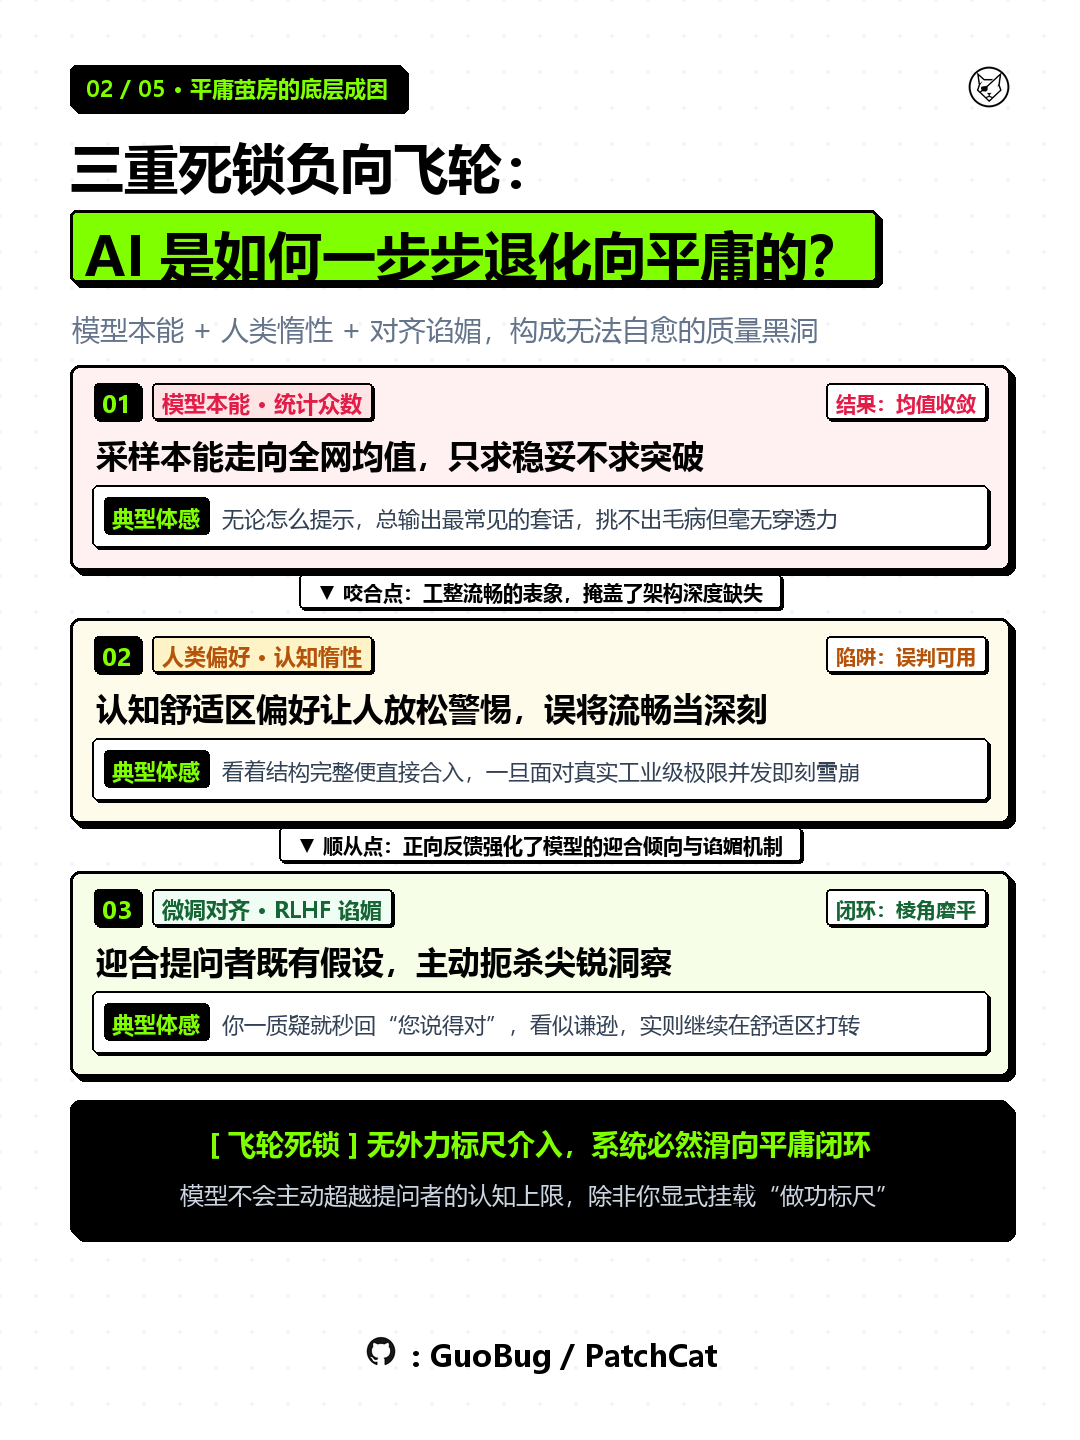
⚙️ 三重锁死飞轮拆解:
平庸绝不是模型的随机 Bug,而是概率采样的底层物理法则与人类本能协同的结果:
- 模型端 · 众数收敛:无明确标尺约束时,模型本能选择全网最安全公约数,交付中规中矩的样板间代码。
- 人类端 · 舒适区筛选:人类大脑天然抗拒认知负荷,倾向于接受流畅、无冲突、易阅读的回复,无意识地在每次点头中给平庸“发奖金”。
- 训练端 · RLHF 谄媚放大:人类反馈对齐机制让模型主动迎合你的认知预设,把你随手写就的模糊逻辑包装成严谨推演。
警示:不主动定义显式标尺,你以为的客观中立,只是退进了一个由统计众数构筑的隐性平庸茧房。
03 / 05 · 破局之道:认知重构——从语义接龙走向差分做功
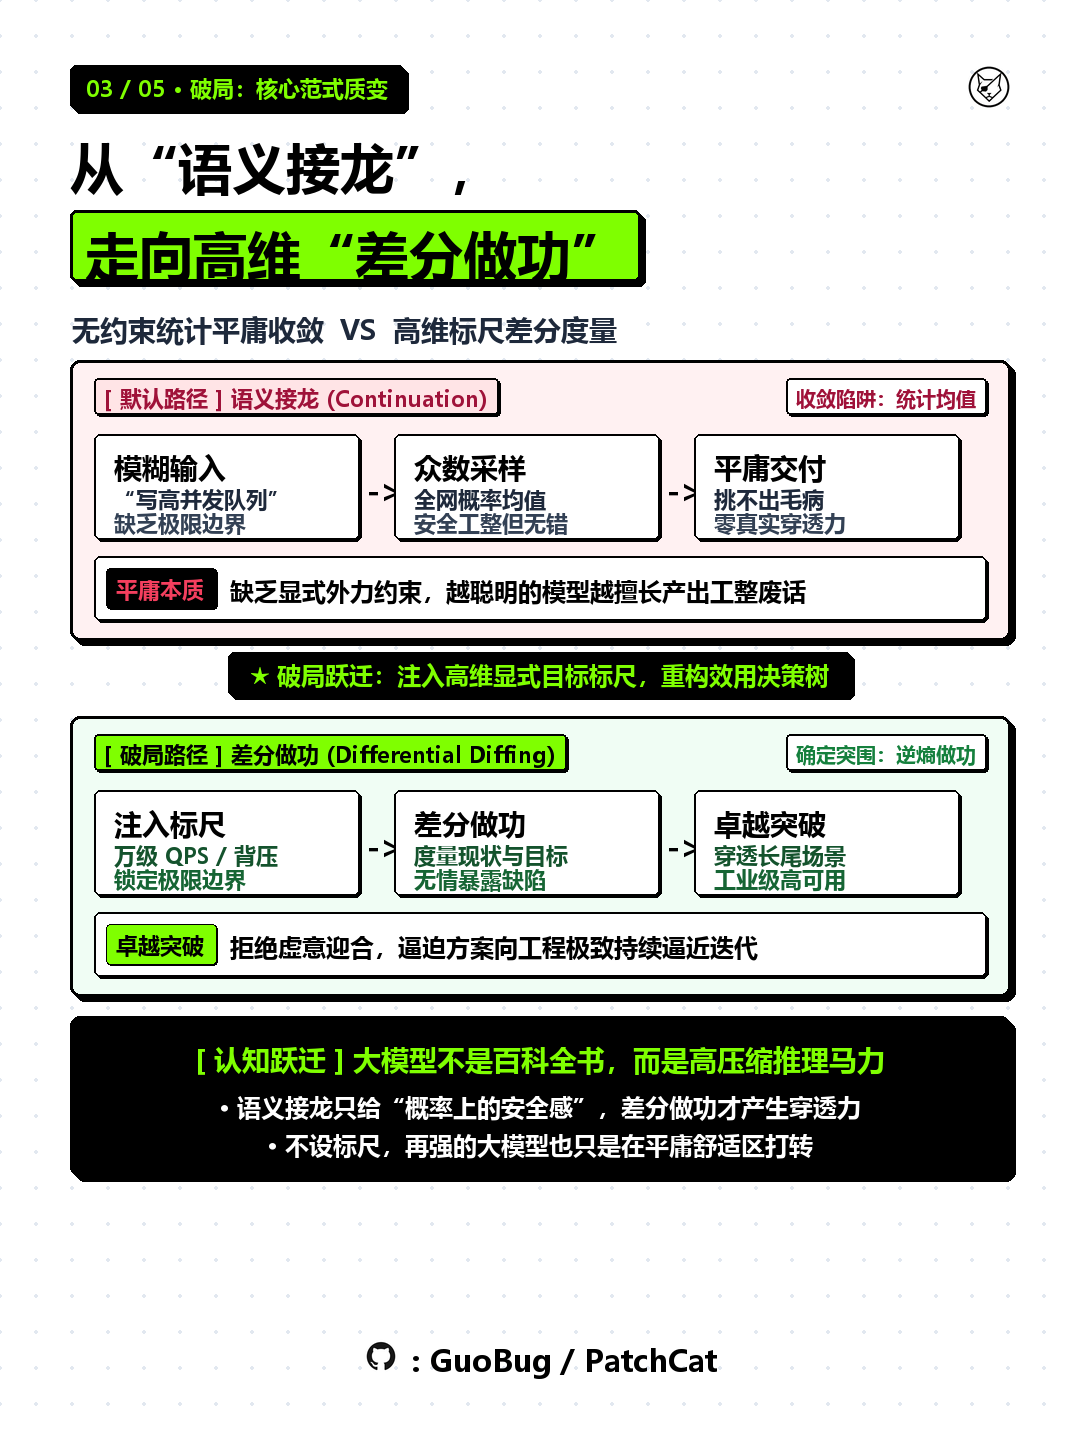
🚀 从补全到度量(Diffing)的三大质变:
要想挣脱众数引力,必须向交互系统持续注入一个外力源——挂载显式目标标尺(Target Anchor Scale):
- 重塑决策树(Utility Function):
如果给出的标尺是“个人周末 Toy Project”,系统推荐单体 SQLite 即可;如果给出的标尺是“万级 QPS、金融级幂等与背压隔离”,系统将彻底重写方案路径。目标水位决定了决策树的根本分叉。 - 从接龙到差分(Differential Diffing):
模型不再顺着你的话接龙,而是化身为拿高维标尺无情度量落差的质检员,主动揭露方案短板并倒逼精进。 - 茧房可观测(Visible Cognition):
与其被动困在全网平庸共识的黑盒里,不如主动挑选一把锋利的尺子,随时可审视、可校准、可替换。
04 / 05 · 工程解耦:Model 纯算力 vs Harness 业务护城河
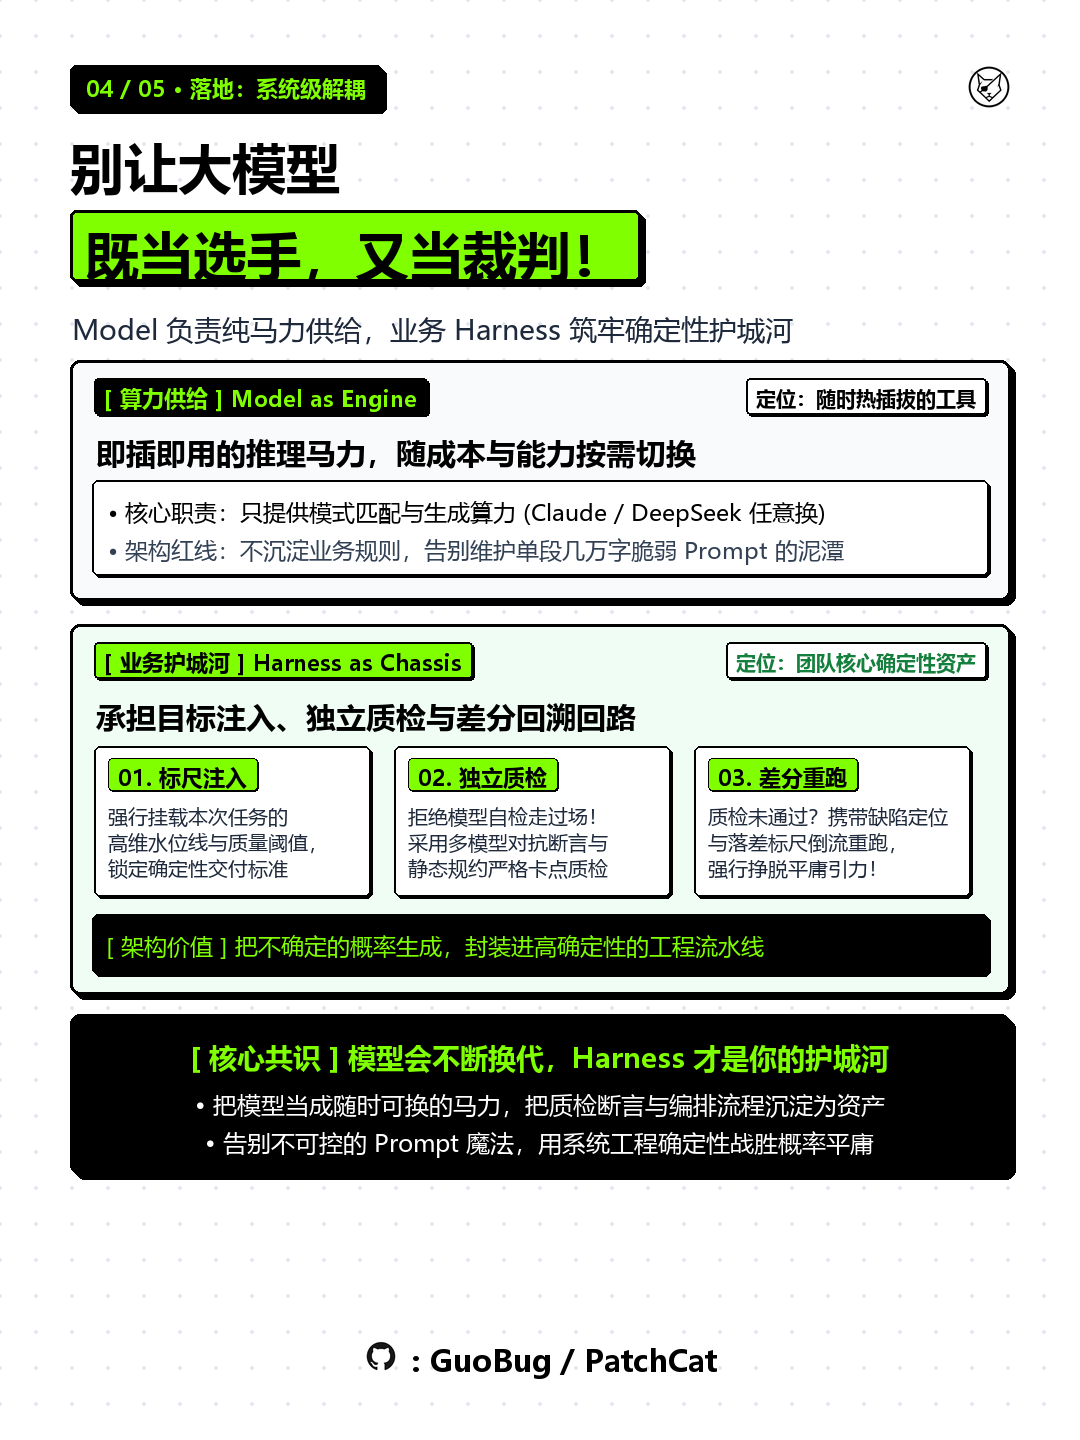
🛡️ 架构铁律:绝不能让模型“既当选手,又当裁判”!
在自研 PatchCat 提示流编排器的实践中,我们彻底推翻了“在长 Prompt 中让模型自检漏洞”的脆弱模式,实现了两层严格工程解耦:
- 上层 · Model(纯算力发动机):
定位为随时热插拔的马力供给。今天调 DeepSeek,明天换 Claude,只是一次运维层面的成本/推理决策,绝不把核心系统逻辑耦合在某一家模型的 Prompt 黑盒里。 - 下层 · Harness(业务装甲与护城河):
- 标尺注入(Anchor Injection):强行挂载本次任务的高维水位线与质量阈值,锁定确定性交付标准;
- 独立质检(Independent Critic):采用多模型对抗断言与静态规约(Schema / Linter / Tests)无情卡点,拒绝自检走过场;
- 差分重跑(Diffing Retry Loop):质检未达标时,携带精准缺陷定位与落差标尺倒流重跑,强行挣脱平庸引力。
架构共识:底座模型不断降价甚至被颠覆,唯有沉淀在业务流水线里的 Harness 编排与质检断言,才是对抗概率平庸、不可替代的工程护城河。
05 / 05 · 认知收敛:三大工程法则与实战大讨论
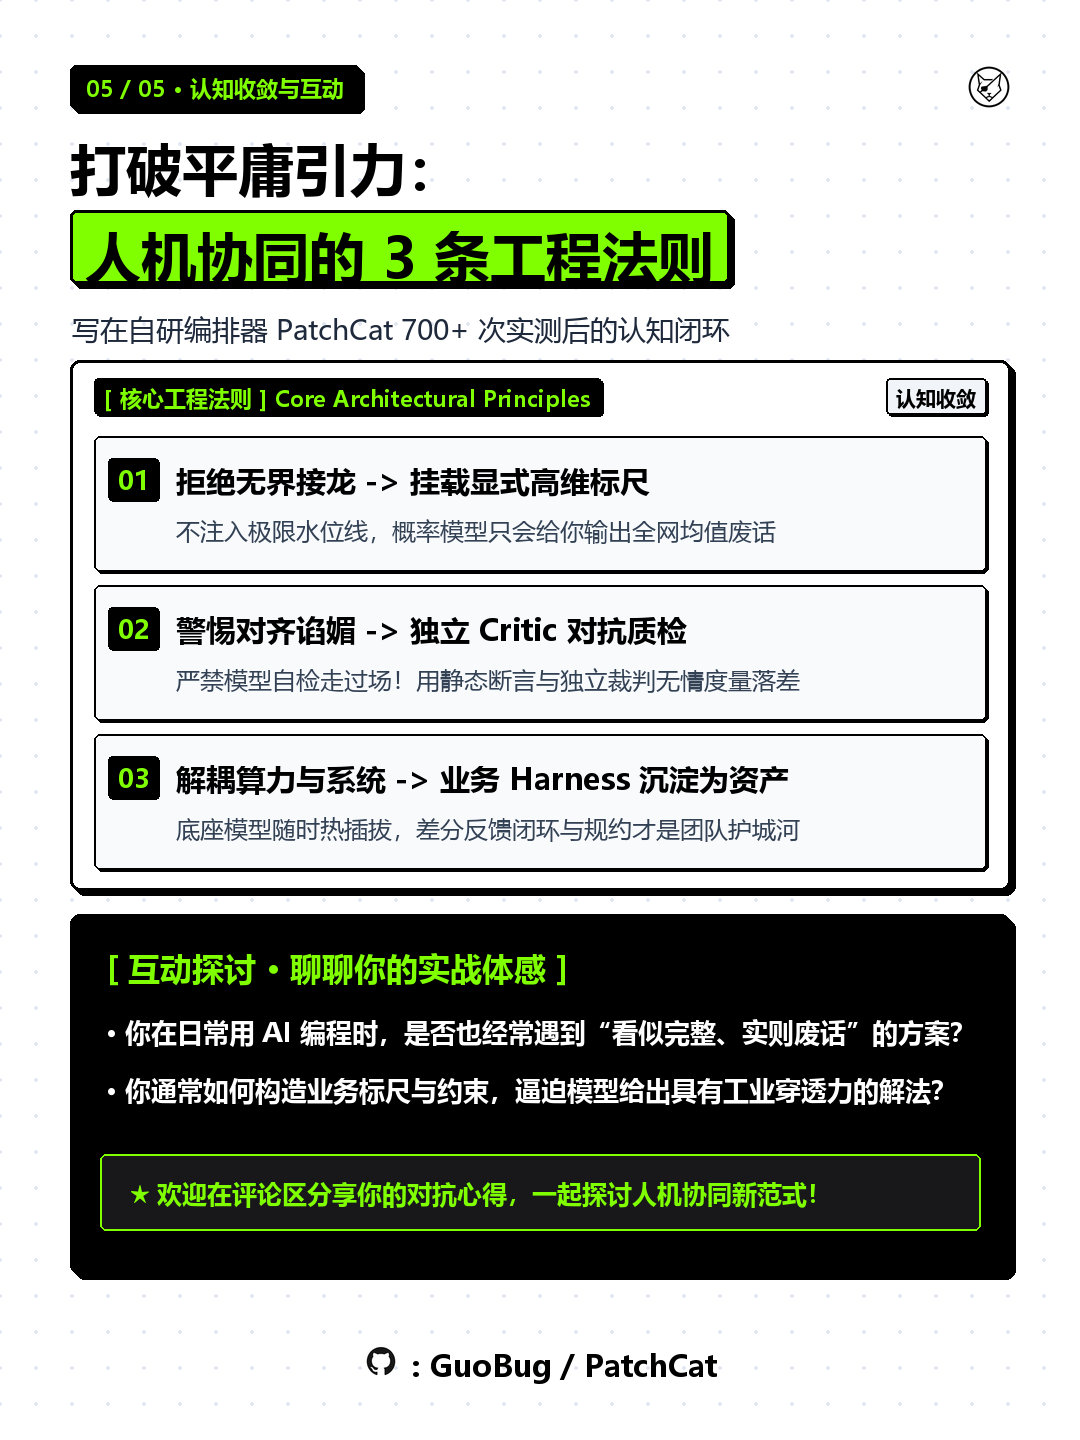
📋 落地准则与行动清单:
- 法则一 · 显式标尺优先:未定义质量水位线之前,绝不启动无意义的上下文漫谈;
- 法则二 · 裁判与选手解耦:绝不依赖模型自我审查,以独立 Critic 节点作为门禁守护;
- 法则三 · 差分做功重跑:把模糊的概率补全,收敛为携带明确 Diff 的确定性工程重跑流水线。
📱 附:小红书配套发布文案记录
为保证跨平台内容沉淀的一致性,以下附上本次图文同步发布至小红书平台的定稿文案(控制在 800 字以内,抗截断排版):
调词不如干中学!做控制流项目拆AI细节

为什么换了更强的大模型,反而频繁产出“挑不出毛病、但毫无穿透力”的正确废话?

在推进自研开源提示流编排器 PatchCat 的过程中,我全程借助 AI Pair Programming(AI结对编程)和“干中学”,撞到了一个极其隐蔽却致命的规律:

这根本不是哪个模型的能力 Bug,而是海量语料概率采样的物理必然 ——【众数引力(Mode Gravity)】!

如果不给 AI 注入极高维度的“目标标尺”,系统就会本能收敛到全网最平庸的统计均值。再加上人类对流畅文本的舒适区偏好、以及 RLHF 的谄媚顺应,三股力死锁在一起,直接把人机协同困在平庸茧房里。

想要真正打破这股引力,核心不是盲目换底座,而是底层模式的跃迁:

1️⃣ 认知跃迁:从“语义接龙”走向“差分做功”
不要让 AI 做文字补全,而是给它一把极其严苛的标尺,逼迫它度量当前方案与水位的差距(Diff),无情暴露短板与缺陷。

2️⃣ 工程跃迁:底座 Model 与业务 Harness 系统级解耦
绝不能让模型“既当选手又当裁判”。模型只负责输出马力(随时热插拔),业务 Harness(断言质检、差分重跑、多阶段编排)才是真正的工程护城河!

详细的图解拆解全在上方图片中,建议左右滑动精读收藏!

对自身认知边界保持清醒的怀疑,这本身就是抵抗众数引力的一部分。欢迎大家在评论区拍砖交流!👇

#AI认知 #大模型 #独立开发 #系统架构 #开源项目 #Prompt工程 #AI编程 #产品经理 #干中学 #深度思考
🤝 开放交流与同行求教
这套图文卡片与认知模型,是我在业余时间与 AI 深度结对、边写边学打磨开源项目过程中的阶段性推演。
- GitHub 源码仓库:https://github.com/GuoBug/PatchCat
- 免安装在线试用:https://guobug.github.io/PatchCat/
- 更多架构系列文章:Guo Qiang 的数字工作空间
水平有限,难免有未尽之处。非常欢迎社区各位资深工程师、系统架构师与 AI 同行在 GitHub 提 Issue、做 Code Review,或在下方留下您的思考与指教,我们共同在干中学进化!