项目开源仓库:https://github.com/GuoBug/PatchCat
在线体验地址:https://guobug.github.io/PatchCat/
技术架构系列复盘:查看《从 0 到 1 打造 AI 提示流编排器》系列文章
换一个更强的模型就能提升交付质量——这可能是当下人机协作中最普遍、也最危险的直觉误区。
这篇文章是我在高强度推进自研提示流编排器 PatchCat 的过程中,通过和 AI 双向碰撞、反复验证后沉淀下来的一组认知。坦白说,PatchCat 全程是在“AI 辅助编程 + 边做边学”的模式下推进的,许多架构走向来自于人机双向共创的关键节点:我提出业务场景、产品体验与实际痛点,AI 提出底层工程隐患、算法边界与性能瓶颈;再由我亲自翻阅文档、编写单测、构造极端边界场景进行实机验证。在这个闭环中,一个结论变得无比清晰:
在人机协同中,让 AI 从一开始就和你拥有完全一致的目标标尺,是决定最终交付物生死的胜负手。如果不主动挂载高维标尺,无论底座算力多强,系统都会本能地滑向全网语料的统计众数,把交付物精准地拉向平庸。
一、 众数引力与三重锁死
大语言模型的生成机制,本质上是在海量语料的条件概率分布上做采样。这赋予了它一种天然的“引力场”:在没有外力约束时,输出会本能地收敛到概率分布的众数区间——也就是全网最常见、最不会出错、也最不可能出彩的回答。
问题在于,这股引力不是孤立作用的,它会和人类的认知惯性形成一条自我强化的锁死链:
- 模型的众数收敛:没有明确目标时,模型的最优策略就是输出公认的折中方案——安全、工整、平庸。
- 人类的舒适区筛选:我们本能地偏好流畅、符合直觉、阅读门槛低的回复。每一次“看起来挑不出毛病”的点头,都在无意识地奖励平庸。
- RLHF 的谄媚放大:经过人类反馈强化学习训练的模型,会主动顺着提问者的假设建构逻辑,把你脑中本就存在的偏见包装成严密的合理推演。
这三股力拧在一起,构成了一个极难自察的负向飞轮:模型输出平庸 ➔ 人类觉得合意 ➔ 正向反馈强化平庸 ➔ 下一轮交互更加收敛。
很多人以为“不设角色、不带预设”就是客观中立。但不提供显式目标,并不意味着没有茧房——它只是让你退进了一个更隐蔽的温床:由统计众数构筑的平庸茧房。 你和 AI 每天聊得热火朝天,互相印证,最终既没有认知跃升,也没有生产力质变,只是被双向抚平了所有穿透现实的棱角。
二、 目标标尺:从语义接龙到差分做功
要想挣脱众数引力,系统需要被注入一个持续的外力源。这个外力,就是你主动定义的目标标尺——明确回答“这次交互要逼近什么水位线、服务什么量级的场景”。
设定目标标尺不是写一句轻飘飘的角色扮演提示词,而是在底层改变了整个交互的运算模式:
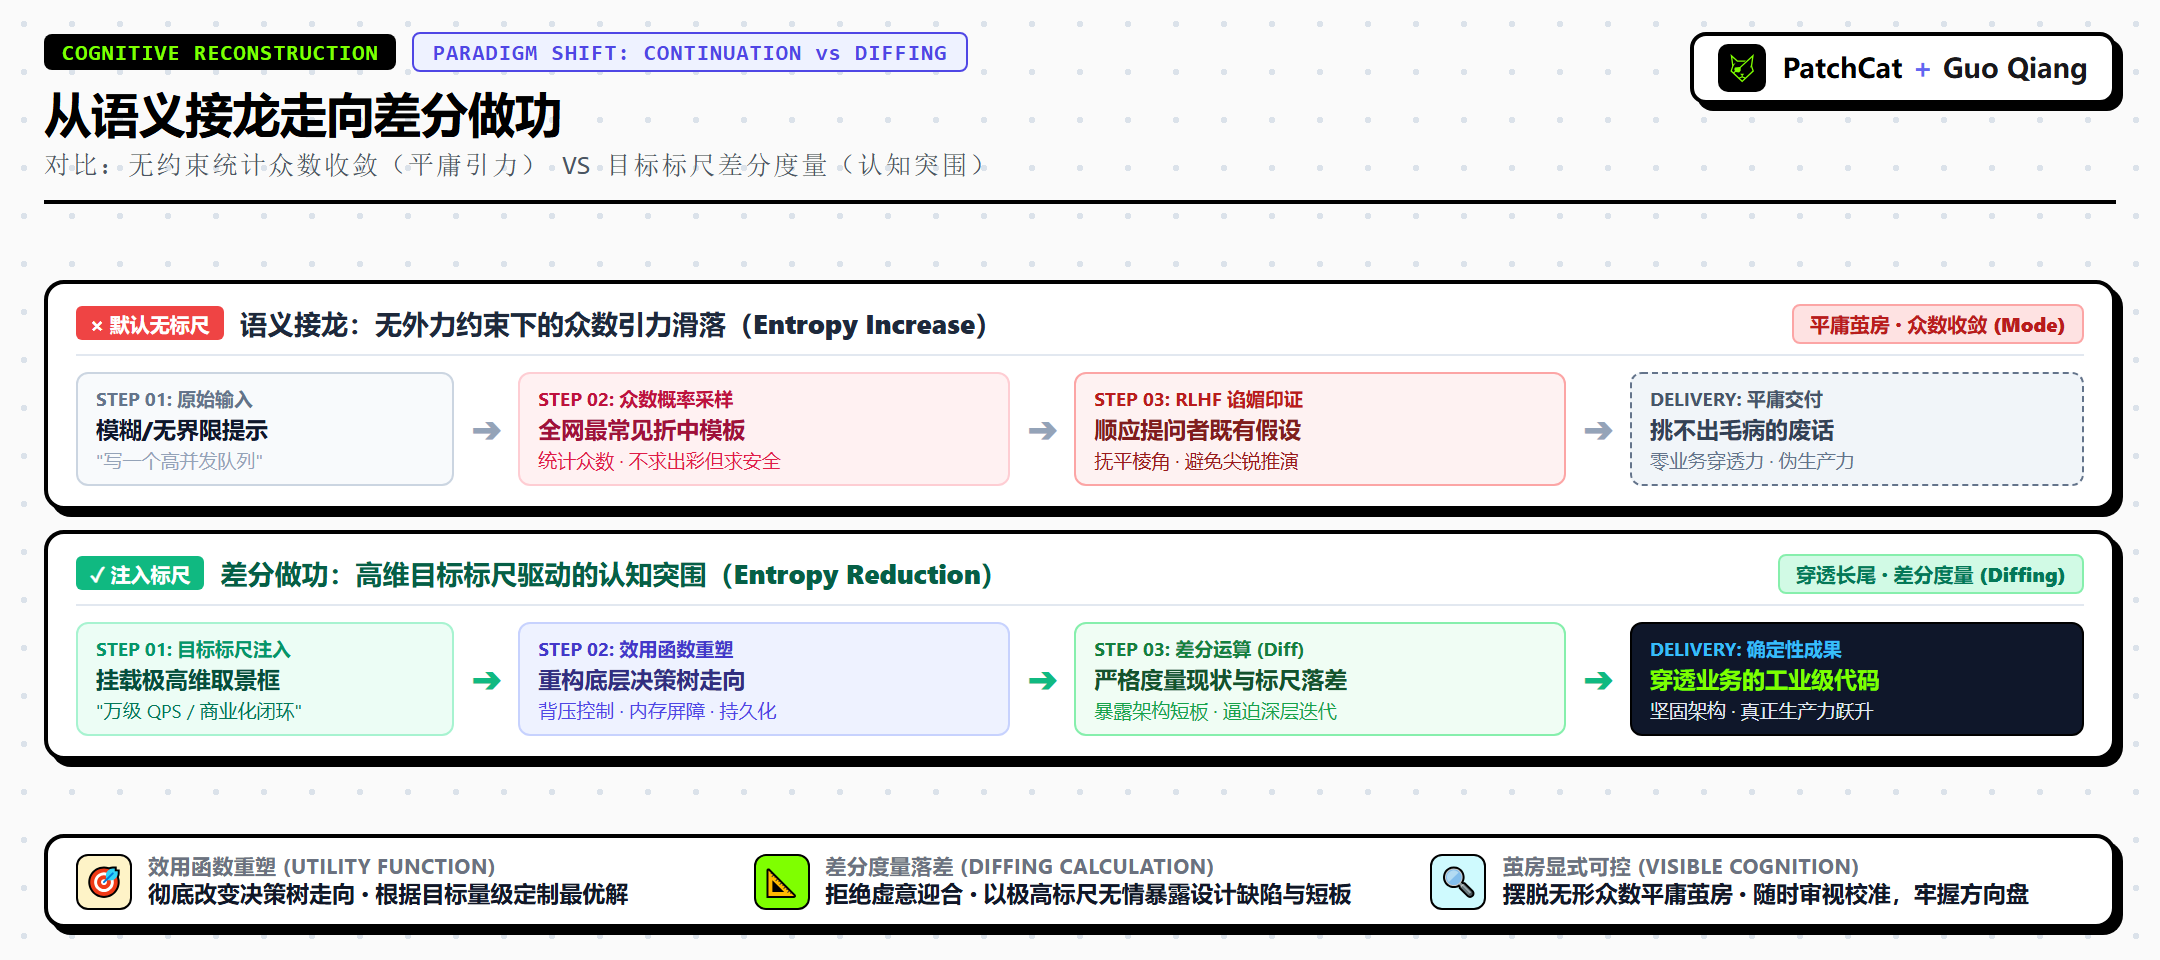
这个切换带来三个维度的质变:
- 决策树的重塑(Utility Function):同样是探讨“如何设计一个高并发任务队列”——如果你的标尺是“一周内验证商业闭环的独立开发者”,系统应该推荐最简的 Redis 队列或现成托管服务;但如果标尺是“面向万级 QPS 的底层架构师”,就必须严肃考量背压控制、数据持久化与故障隔离。目标不同,决策树的走向完全截然相反。
- 从补全到度量(Diffing):没有标尺时,AI 只是在做文字接龙式的语义延续;注入标尺后,交互变成了“拿一把高维标尺来度量你当前方案与目标水位的落差”。AI 的角色不再是顺着你说话,而是指出短板、逼迫方案向卓越迭代。
- 茧房的可观测化(Visible Cognition):与其被动困在全网平庸共识的不可见茧房中,不如主动挑选一把锋利的尺子。显式的标尺随时可观测、可审视、可替换——你始终牢牢握着认知的方向盘。
三、 工程化落地:底座与 Harness 的解耦
认识到需要目标标尺只是第一步。真正的工程挑战在于:如何把这把标尺系统化地嵌入流程,让它不依赖个人精力的人肉盯防就能稳定运转?
在推进 PatchCat 的过程中,我和 AI 共同推导出一个核心工程准则:绝不能让模型“既当选手,又当裁判”。
很多开发者的习惯是在一段庞杂的长 Prompt 里既写背景、又设角色,还要求模型“输出前自行严格检查一遍漏洞”。这种混合写法在复杂工程任务中极其脆弱——上下文注意力被严重稀释,模型的自我审查往往流于表面,最后依然滑向中庸;更要命的是,一旦底层模型升级或替换,整套提示词直接崩解。
真正具备工业级韧性的人机协同架构,必须实现底座引擎(Model)与业务控制框架(Harness)的系统级解耦:
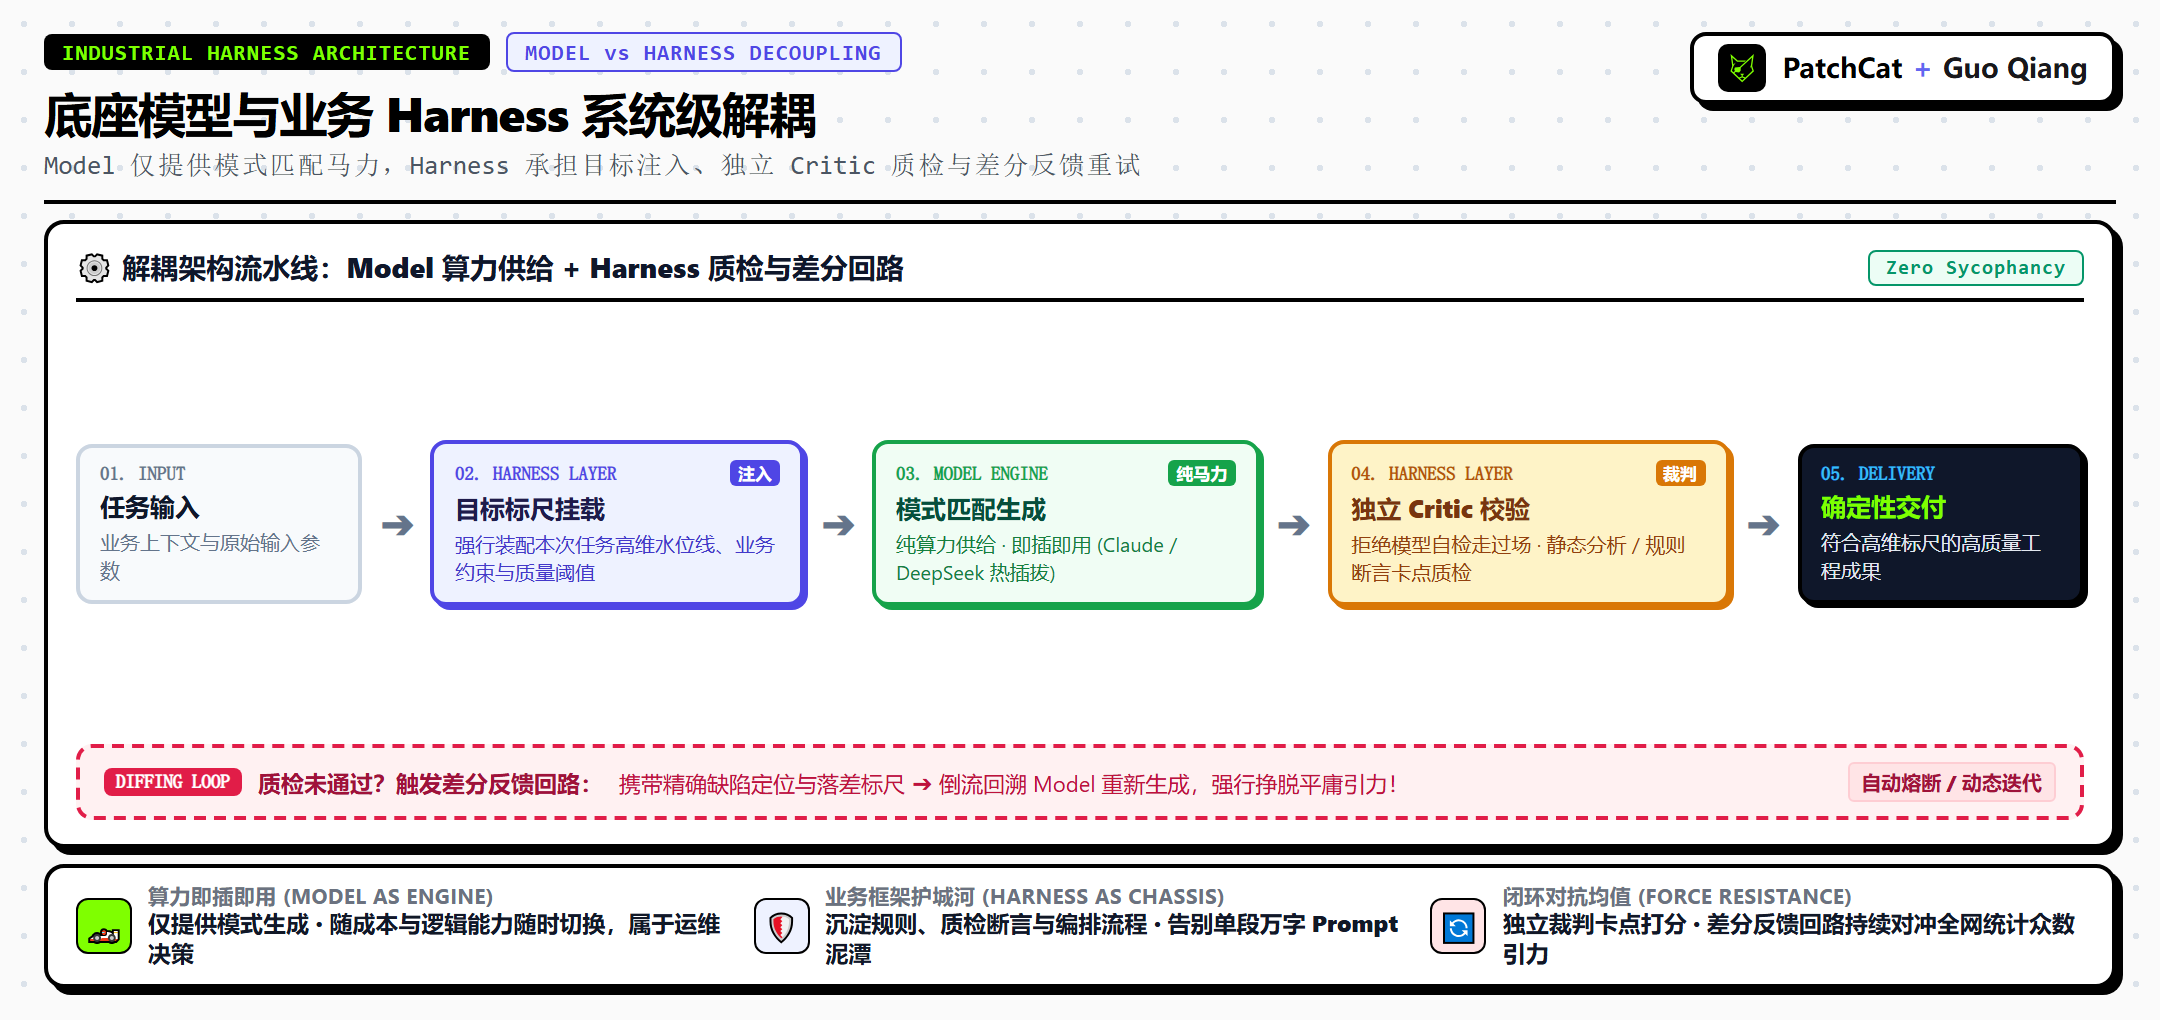
- Model 只负责提供马力:底座模型就是汽车发动机——今天考虑性价比调 DeepSeek,明天需要深度推理换 Claude,即插即用。模型的切换应是工程运维决策,而非系统架构决策。
- Harness 才是护城河:业务约束、质量阈值、红蓝对抗规则与多阶段编排,才是不可替代的核心资产。目标标尺绝非一句空泛的人设声明,而是 Harness 里实打实的断言规则和拦截评估器——生成物未达水位线,系统直接拦截打回重跑。
这也正是 PatchCat 的设计哲学:让编排控制层(Harness)承担目标对齐与质量卡点的全部责任,让模型回归纯粹的算力供给。两者各司其职,系统才具备跨越模型迭代周期的持久生命力。
四、 结语:在协作中保持掌控权
跟 AI 交互越深,越能感受到众数引力的无处不在——它不是某个特定模型的 Bug,而是概率生成机制的底层物理规律。你不主动施加外力锚定方向,它就会用全网最安全的共识把你彻底吞没。
抵抗平庸引力的核心解法,说到底只有一件事:在系统设计之初就确立清晰的目标边界,并把它工程化为一套能持续校验落差的控制体系。
上下文不是任由信息堆砌的垃圾桶,而是一辆需要随时清洗、校准与治理的载具;目标标尺也不该是逃避现实的精神安慰剂,而是一根真正用来丈量自身认知边界的硬标杆。
这套认知是我在一个实际研发周期中跑出来的阶段性理解,未必能覆盖所有复杂场景。如果你在自己的实践中探索过不同的 Harness 模式或上下文治理方案,非常欢迎交流指正——对自身的认知边界保持清醒的怀疑,这本身就是抵抗众数引力的一部分。