项目开源地址:GitHub - FerryCat · 对应源码实现:src/supervisor.ts: 执行主管与长任务看门狗 与 测试用例 Test 13: 崩溃与超时残片打捞验证
前篇专栏回顾:📖 抢麦发言防撞车:基于 UUID 租约令牌的多 Agent 无锁并发治理
在线下研发团队里,技术主管最担心的协作状态之一,就是下属领了任务之后“闷头苦干到失联”。
早上站会分配了一个重构任务,某个核心开发领了需求回到工位,既不向上汇报进度,也不在群里同步风险。两个小时过去,整个项目流水线被完全卡死。主管走过去询问才发现:对方卡在一个诡异的类型报错里推倒重来了三次,最终无功而返。
在多 Agent 协同编程的世界里,这种“失联蒸发”带来的代价更加惨痛。
当一张工单涉及数千行代码的白盒扫描、跨文件依赖推演或复杂的自动化测试生成时,大模型的推理耗时动辄长达数分钟,消耗上万 Token。若协作中枢缺乏专业的进程监督机制,大模型常常因稍稍超出预设的执行时间窗口,被底层直接一刀切判定为 TIMED_OUT。
最令人抓狂的是:大模型辛辛苦苦推演了 299 秒、只差 1 秒就要输出最终交单 JSON,整个进程就因为超时被系统强制杀死,所有已经生成的宝贵推演结论瞬间化为乌有。
今天这篇,我们深入 FerryCat 的长任务治理体系,聊聊如何通过动态惰性心跳保活与超时残片打捞机制,彻底终结这种算力黑洞。
一、 痛点根源:At-most-once 丢产物到底有多致命?
在分布式系统与消息队列的设计中,At-most-once(至多一次)隐性丢失 是最令人头疼的 P0 级设计陷阱。
传统的工作流框架在调度子进程执行任务时,往往采用极为原始的定时器看门狗模式:
- 启动子进程,开一个 60 秒的计时器;
- 如果子进程在 60 秒内正常返回,收录产物并完成交付;
- 如果时钟走到第 61 秒子进程仍未退出,看门狗向操作系统下发
SIGKILL强杀信号,同时在数据库中把工单标记为终态TIMED_OUT。
在普通的短平快脚本场景下,这种设计看似干脆利落。但在以大模型为核心执行主体的 AI 工作流编排 场景下,这是一种灾难性的粗暴设计:
- 算力彻底浪费:大模型推演了数百秒、消耗了昂贵的高阶思考 Token,所有的中间成果就躺在子进程的内存与标准输出(stdout)管道缓冲区中;
- 诊断线索完全抹杀:由于进程被强杀、管道被释放,发起方收到的仅仅是一个冷冰冰的超时状态码,完全无从得知模型究竟卡死在哪个逻辑分支;
- 缺乏断点续跑可能:下游工作流或者人工排查者无法基于大模型已写好的 90% 半成品进行审查与纠偏,必须重头再来。
一个工业级的协同中枢,绝不能在下属努力工作时盲目按下斩首开关。
二、 第一道防线:心跳配额早衰陷阱与惰性续期
为了防止任务因耗时长而误超时,最直观的解法是引入心跳保活(Heartbeat Keep-Alive)机制。
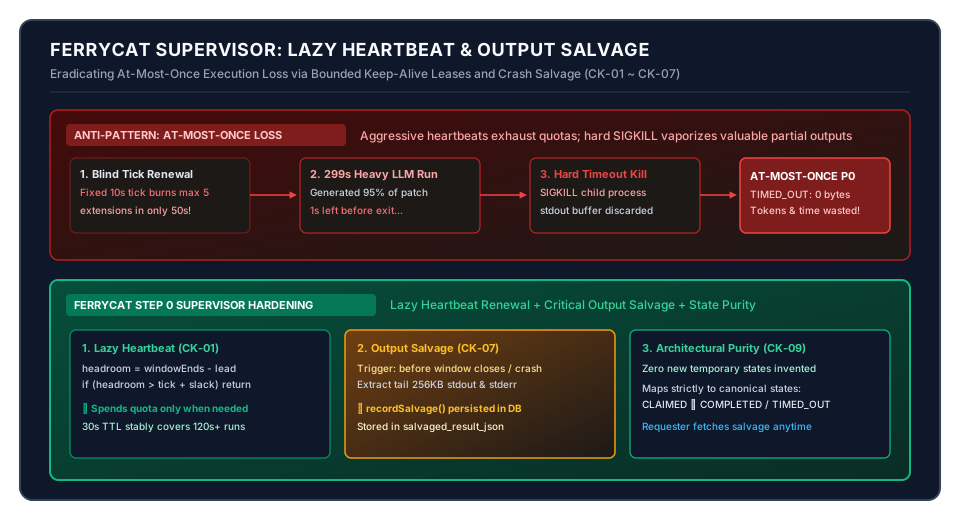
为了杜绝恶意死循环占用资源,FerryCat 引擎在底层状态机中对工单施加了严格的防御性约束:一张工单在单次认领周期内,心跳续期的总次数是有上限的(例如硬性限制 MAX_TTL_EXTENSIONS = 5)。
这里埋藏着一个极其隐蔽的心跳早衰陷阱(在 CK-01 验证阶段被白盒剖析出):
假设某工单单次执行窗口 exec_ttl 设为 30 秒。如果执行主管采用朴素的固定心跳逻辑——设置一个每 10 秒触发一次的定时器,只要子进程还在跑,就立刻调用 extend_ttl:
// 错误示范:致命的心跳配额过早耗尽!
setInterval(() => {
  if (childIsAlive()) {
    engine.extendTtl({ contract_id, claim_token }); // 盲目续期!
  }
}, 10000);
其灾难性后果显而易见:
- 第 10 秒,消耗第 1 次配额;第 20 秒,消耗第 2 次;第 50 秒时,整整 5 次续期配额就被毫无节制地挥霍一空!
- 此时任务仅仅运行了 50 秒,而配额已经见底;
- 到第 80 秒时,原先完全正常且合法的超长任务,不得不因为配额早衰被系统硬生生掐死。
为了让有限的心跳配额发挥最大价值,FerryCat 在 src/supervisor.ts 中自研了惰性续期(Lazy Renewal)算法。
执行主管不再机械地逢 tick 必续,而是在每个心跳周期内动态评估当前时间窗口的剩余余量(headroom):
// 只有在下一次 tick 会踏入警戒线时,才真正发起续期
const headroom = windowEndsAt - guardLeadMs - Date.now();
if (headroom > tickMs + renewSlackMs) {
  return; // 余量充足,拒绝浪费宝贵配额
}

const res = engine.extendTtl({
  contract_id: contract.contract_id,
  claim_token: token,
});
通过这套算法,只要当前时间窗口的余量还能撑过下一个心跳周期,执行主管就绝不乱花一次配额。仅在距离窗口关闭前的安全警戒线(guardLeadMs)仅剩最后毫秒时,系统才精准地发起一次续期,将截止时间推后。
这一精打细算的机制,让 5 次看似微薄的续期配额,稳稳支撑起原本 30 秒 TTL 的工单持续健康运行 120 秒以上,优雅覆盖了复杂任务的推演周期。
三、 动态防线:容忍网络与并发微抖动
在真实的桌面开发环境中,操作系统由于内存换页或高负载,或者 SQLite 数据库正在进行短事务写入,心跳请求偶尔会遇到微秒级的短暂冲突或延迟。
如果心跳请求只要抛出一次异常就直接把子进程杀死,系统可用性会极具脆弱性。
在 CK-03 契约安全加固中,我们确立了一条原则:绝不允许心跳层面的微小故障直接扼杀正在正常推演的子进程。
当心跳续期遇到异常时,执行主管会执行轻量探针复核(stillOwnsLease()):
- 快速读取数据库中的租约快照;
- 如果工单仍然属于当前 Agent 且令牌完全匹配,说明租约本身并没有丢失,仅仅是遭遇了短暂瞬态抖动,此时保留子进程继续运行;
- 仅当租约在物理层面确实已被外部管理员强制撤回或工单已不可逆失效时,才触发级联终止。
当 5 次续期配额真正合法耗尽时(budgetExhausted),系统同样保持克制:停止发起无意义的网络续期,转而维持最终的倒计时警戒线(Guard Armed),留给子进程最后的安全宽限期(killGraceMs),为接下来的终极打捞做好准备。
四、 核心破局:超时残片打捞机制(CK-07)
如果一个任务由于业务复杂度实在过高,最终还是无可避免地走向了超时或非零退出,我们该如何保全它的推演价值?
这就是 FerryCat 架构中最具温情也最严谨的设计:超时残片打捞机制(Partial-Output Salvage)。
执行主管的铁律是:绝不允许任何一次子进程终止空手而归。
在执行窗口即将绝对关闭的前夕,或者在子进程崩溃、被信号中断的毫秒级瞬间,执行主管会第一时间拦截现场,调用紧急打捞函数 salvageNow():
const salvageNow = (source: string) => {
  if (!stdout && !stderr) return;
  if (salvaged) return; // 幂等保护

  // 截取最后 256KB 的精华推演内容
  const tailStdout = stdout.slice(-SALVAGE_TAIL_CHARS);
  const tailStderr = stderr.slice(-SALVAGE_TAIL_CHARS);

  const ok = engine.recordSalvage({
    contract_id: contract.contract_id,
    claim_token: token,
    salvage: {
      source,
      salvaged_at: Date.now(),
      stdout_tail: tailStdout,
      stderr_tail: tailStderr,
      exit_code: sup.child.exitCode ?? null,
      signal: sup.child.signalCode ?? null,
    },
  });
  if (ok) salvaged = true;
};
执行主管利用操作系统管道中残存的流数据,提取出尾部整整 256KB 的精华推演日志与半成品代码,并通过底层的 recordSalvage 接口,原子化地固化进数据库的 salvaged_result_json 字段中。
随后,子进程才被安全、体面地回收。
这一设计在 确定性工作流 中产生了深远的工程收益:
- 发起方在收到工单超时的通知时,调阅工单详情,即可直接提取出模型已经写出的 95% 代码与关键思路推演;
- 开发者可以直接人工采纳该半成品补丁,也可以把这些残片数据作为上下文锚点(Checkpoint)无缝投喂给下一张工单,让下一个 Agent 基于已完成的进度断点续跑;
- 算力成本被有效封存,彻底根除了 At-most-once 的黑洞式浪费。
更关键的是,根据 CK-09 架构规约,系统在落地打捞时没有强行发明任何冗余的临时状态。底层 DAG 状态机 依旧忠实地在 CLAIMED -> TIMED_OUT / FAILED 之间规范流转,而打捞数据仅仅作为工单的自包含元数据进行沉淀,捍卫了有限状态机的数学纯粹性。
五、 代价与适用边界
面对任何技术方案,秉持务实审慎态度的 Product Engineer 都必须看清其代价与边界:
- 内存管道缓冲的物理上限:执行主管为了打捞,必须全程监听并暂存子进程的 stdout/stderr 流。如果子进程陷入恶意死循环疯狂打印海量垃圾日志,会迅速撑爆内存。因此 FerryCat 施加了硬性上限(默认
maxBufferBytes = 10MB),一旦缓冲区溢出立即触发保护性熔断; - 残片产物的非生产就绪性:被打捞上来的代码本质上是未通过语法完整性检验与契约校验的暂态草稿,它只能作为开发者的诊断依据或断点续跑参考,严禁未经审查直接合入生产代码库;
- 单机监督进程的算力开销:每个自动执行的 Worker 都需要配备一个常驻事件循环监听器与轻量定时器。在个人工作站上并发调度 5~10 个智能体实例毫无压力,但若扩展至大规模服务器容器编排,则需依赖更底层的内核级 cgroups 监控。
六、 结语:让每一次计算都有尊严
在构建复杂的 AI 协作体系时,确定性并不仅仅意味着在理想路径下一帆风顺,更体现在对异常残局的敬畏与托底。
通过单语句 CAS,我们让 Agent 抢单不撞车;通过 UUID 租约,我们杜绝了同名冒充;而通过执行主管的惰性心跳续期与超时残片打捞,我们为长达数分钟的重型推演任务撑起了一张坚不可摧的安全气垫。
大模型耗费算力推演出的每一行代码与每一次思索,都有据可查、有迹可循、绝不白费。
然而,当一个超时任务的残片被成功打捞、中枢决定终止它的运行生命周期时,另一个极其凶险的操作系统级暗坑随即浮现:如果这个子进程在执行期间,背着中枢悄悄衍生出了一整棵庞大的“孙进程树”(例如用 npm 或 pytest 启动的底层测试套件),当中枢下达杀进程指令时,如何确保这些隐蔽的孙进程不会变成游离在后台的孤儿,暗中修改源码污染下一次评审?
下一篇,我们将直面进程树治理的底层迷宫:拆解跨平台孙进程树递归清理与孤儿暗箱操作的彻底清扫。
专栏与开源项目
FerryCat(跨宿主 AI 智能体契约编排中枢):https://github.com/GuoBug/FerryCat
欢迎 Star 关注或提交 Issue 交流。本专栏全部演进过程与实录工单均已在仓库内完全开源。关于作者
郭强 (GuoBug),Product Engineer,做平台工程也做业务增长。目前主要在折腾 AI 工作流编排、DAG 状态机与确定性系统架构。
开源项目与主页:https://github.com/GuoBug · https://gu0bug.github.io
欢迎就工作流引擎架构、拓扑调度和低门槛开发体验交流指教。