项目开源地址:https://github.com/GuoBug/PatchCat
在线体验:https://guobug.github.io/PatchCat/
往期回顾:
📖 《从 0 到 1 打造 AI 提示流编排器:搞 Eval 评测前,先让输出闭合!结构化约束与业务契约防线(开源系列 14)》
📖 《从 0 到 1 打造 AI 提示流编排器:别让 Agent 刷爆你的信用卡!运行时看门狗与死循环熔断器设计(开源系列 13)》
📖 《谁来为大模型的失控与手滑兜底?一个 Product Engineer 的「零信任」数字生存反思》
一句话:大模型输出 JSON 并非是在填表格,而是依托自回归自注意力机制构建的连续语义场。不要用静态代码的机械拼装,去强行割裂自回归的上下文。
一、一次看似精妙的“局部微创手术”
在持续测试工单智能分发与格式审查等长流程时,我们遇到了一个很现实的痛点:
一个严谨的业务 Schema 通常包含十几个字段,不仅有枚举、数值,还有耗费大量算力总结的 summary(长文本摘要)与 reasoning(多步推理链)。
1. 直觉发难:为什么要让模型全量重写?
在实测中我们发现:很多时候模型吐出的 10 个字段里,有 9 个推导得极其精准,仅仅是其中某 1 个数字字段(如 urgency: 9)越界了。
如果让大模型重新生成全量 JSON:
- 额外浪费 Token:原本推导合理的数百字长文本摘要需要全量重新生成一次;
- 引发次生风险:大模型有可能在重写时,把原本已经写对的长文本意外改崩(发生次生语义漂移)。
2. “字段级冻结(Field Freezing)”的设想
针对这个痛点,我们构思了一个局部的优化方案:
- 第一步(内存冻结):将校验通过的 9 个合法字段在内存中强制冻结锁定;
- 第二步(精准抽离):只将那 1 个报错的字段抽离出来,作为待修补的局部 Prompt 喂给模型;
- 第三步(机械缝合):模型只需返回单字段的修补结果,系统在 TypeScript 层面用代码将新旧字段合并(Merge)。
根据长文本摘要与单字段的 Token 占比测算,这个优化在重试阶段理论上能节省大半 Token 开销,且看似杜绝了正确字段发生漂移的可能。我们写了 60 多行局部抽取与合并逻辑,推上了测试流水线。
二、翻车复盘:Case #7 极限压测下的“局部最优解死锁”
然而工程现实很快给出了反馈。当测试流水线跑到第 7 个极限用例(Case #7:复杂跨字段约束工单)时,控制台大面积飘红,流程陷入了长时间的停滞,最终重试耗尽宣告失败。
1. Case #7 的业务契约背景
Case #7 模拟的是售后工单中严苛的“高危工单深度阐述”与“意图退款联动”场景。在 Zod(L2)层面,我们通过 superRefine 构筑了一道跨字段业务守卫:
- 当工单被标记为最高紧急度(
urgency >= 4)时,summary字段不得少于 15 个字,必须包含充分的排查理由; - 若分类意图涉及退款,必须联动给出非空的订单号。
2. 致命死锁过程还原
在 Case #7 的初次生成中,大模型生成了 urgency: 5,但其 summary 只随手填了一句 10 个字的短句("订单待发货,急需送达")。
接下来,死锁在字段级冻结中爆发了:
- L2 拦截判定:语义校验器触发联动报错,判定高紧急度工单摘要字数不足,抛出跨字段冲突处方;
- 冻结逻辑介入:系统自作聪明地把其余字段(包括导致该冲突的根源字段
urgency: 5以及分类字段)在内存中全部冻结锁定; - 陷入死锁的第 2 轮:系统把其余字段剥离,只要求模型重写
summary。然而在割裂了整体业务背景的局部视野里,模型根本不理解为什么这句简短的概括通不过; - 机械合并后的冲突再现:模型在缺少全局上下文的情况下随意重写了几个词;缝合后的对象再次送入 L2 校验,依然无法自洽;
- 循环彻底耗尽:报错信息又被喂回给模型,但由于
urgency处于冻结盲区,模型无法通过主动调整优先级来化解冲突;模型被迫在残缺的上下文里反复横跳,直到重试次数彻底耗尽,测试全线崩溃。
三、认知升华与果断回滚:工程上的“断舍离”
面对飘红的 Case #7,我们面临两个架构选择:
- 方案 A(打补丁路线):继续在局部冻结的基础上加码,为 Schema 中的字段构建有向依赖图(Field Dependency Graph),动态分析哪些字段受联动影响并解除冻结;
- 方案 B(断舍离回滚):承认字段冻结的设计假设在本质上违背了大模型的工作原理,彻底删除局部冻结逻辑,回归全局上下文修复。
1. 底层原理认知:大模型是“连续语义场”
在与 AI 搭档推演大模型注意力机制的条件概率分布后,我们理清了根本原因:
人类写代码习惯于模块化拼装和单点打补丁;但大模型输出 JSON 并非是在填表格,而是依托自回归自注意力机制构建的 连续语义场。字段与字段之间存在着紧密的隐性语义概率依赖。
当我们用静态代码强行冻结一部分、修补另一部分时,本质上是用人类主观的机械拼图思维,强行制造了一个充满语义断层与上下文剥离的残缺提示词。
2. 果断回滚(Rollback)
在工程实践中,懂得何时回滚比硬撑一个错误的设计更具价值。
我们当机立断:彻底删除全部 60 多行字段冻结与局部合并代码,完全回归“原输出全量残片 + 字段诊断 + 黄金范式”的全局修复路线。
3. 实测佐证:回滚后的完整执行日志
回滚后的表现立竿见影。以下是引擎回归全局三元组后,真实运行在 Case #7(跨字段业务契约拦截)场景下的原始执行 Trace 日志(截取自 测试日志及截图/跨字段业务契约拦截.log):
### 🛡️ AI 工作流确定性结构化输出与自愈状态机复盘日志

- **执行结果**: ✅ 自愈成功 (经历 2 轮调用,1 次自动纠偏)
- **总调用轮次**: 2 轮 (最大自愈预算: 2 次重试 / 3 次总调用)
- **双层防御网**: L1 格式约束 (json_schema / json_object) + L2 业务契约深度校验 (Zod safeParse)

---

#### 📜 轮次执行明细 (Execution Trace Timeline)

##### 🔹 Round 1 (初次生成 / Initial Generation)
- **Finish Reason**: `stop`
- **L1 语法层**: ✅ 语法解析合法 (Syntax Valid)
- **L2 业务契约层**: ❌ 规则拦截 (Caught by L2 Semantic Defense, 1 处违规)
- **契约拦截明细 (Field Diagnostics - 违规值/约束/处方三要素)**:
  - `[summary]`: 合规要求:高优先级工单 (urgency ≥ 4) 的 summary 至少需要 15 字阐述详情理由
    * 实际输出值: `订单待发货,急需送达`
    * 约束规则: 合规要求:高优先级工单 (urgency ≥ 4) 的 summary 至少需要 15 字阐述详情理由
    * 修复处方: 检测到跨字段业务规则冲突,请调整字段 "summary" 以满足业务逻辑限制 (当前输出值: "订单待发货,急需送达")
- **本轮原始输出**:
{
  "urgency": 5,
  "category": "logistics",
  "summary": "订单待发货,急需送达",
  "orderId": "ORD-123456"
}

##### 🔹 Round 2 (第 1 次自愈重试 / Self-Healing Retry #1)
- **Finish Reason**: `stop`
- **L1 语法层**: ✅ 语法解析合法 (Syntax Valid)
- **L2 业务契约层**: ✅ 全部通过 (Semantic Valid)
- **本轮原始输出**:
{
  "urgency": 5,
  "category": "logistics",
  "summary": "昨天购买的订单一直显示待发货,急需送达,否则将要退款",
  "orderId": "ORD-123456"
}

---

#### 🎯 最终收敛结构化数据 (Final Validated Contract Output)
{
  "urgency": 5,
  "category": "logistics",
  "summary": "昨天购买的订单一直显示待发货,急需送达,否则将要退款",
  "orderId": "ORD-123456"
}
从真实的 Trace 日志中可以清晰看到:在保留完整全局上下文后,大模型在第 2 轮精准领会了跨字段要求,将摘要扩充至 17 个字("昨天购买的订单一直显示待发货,急需送达,否则将要退款"),整个自愈流程在第 2 轮耗时仅约 400ms 便顺利通过。
四、L4 终极防线:当 3 轮重试全部耗尽,系统如何“绝不崩溃”?
虽然回归全局修复在基准测试样本中大幅提升了自愈收敛率,但作为一个严肃的 PatchCat 编排引擎,我们必须面对不可回避的失效场景:
如果模型遭遇了极端恶意的 Prompt 注入、API 彻底超时,或者 3 轮重试后依然无法合规,系统该怎么办?
1. 传统代码的灾难做法:throw new Error()
在单体脚本或简单的 Demo 里,很多人的做法是在 3 次失败后直接抛出异常:
// ❌ 灾难性的做法:直接炸毁工作流
if (!isValid && retries >= MAX_RETRIES) {
  throw new Error("Failed to generate structured output after 3 retries");
}
这在 DAG 状态机中是灾难性的。工作流往往包含多个并发分支与下游待触发节点。一旦核心节点直接未捕获异常抛出,整个运行进程崩溃,所有中间已执行节点的成果丢失,画布上的节点永远卡在 Pending 状态,给终端用户带来极度糟糕的卡死体验。
2. PatchCat 的 L4 优雅降级(Never-Throw Guarantee)
为了保障工作流流水线的绝对确定性,我们在 L4 层树立了一条硬性工程规约:无论遭遇多么恶劣的输出,结构化输出引擎绝不允许向上抛出致命异常导致流程中断。
当重试全部耗尽时,系统执行确定性优雅降级,返回一个带有特殊元数据的合规对象:
// ✅ L4 优雅降级:绝不崩溃,带状态向下流动
return {
  _validationFailed: true,               // 明确标记降级状态
  _rawText: lastRawResponse,            // 完整保留最后的原始输出
  _validationErrors: lastErrors,        // 附带完整的 Zod 诊断路径
  _fallbackData: defaultFallback || {}   // 附带默认安全垫数据
};
3. 实测证据一:3 次重试彻底耗尽时的控制台 Trace
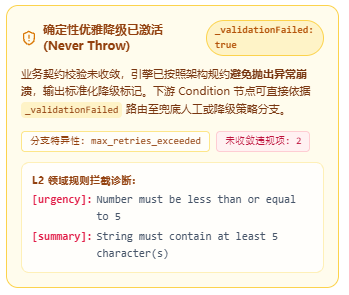
以下为我们故意构造恶意输入、诱发模型连续 3 次校验失败时的真实系统 Trace 日志(截取自 测试日志及截图/连续 3 次失败.log):
### 🛡️ AI 工作流确定性结构化输出与自愈状态机复盘日志

- **执行结果**: ⚠️ 优雅降级兜底 (_validationFailed: true,未向外抛错)
- **总调用轮次**: 3 轮 (最大自愈预算: 2 次重试 / 3 次总调用)
- **双层防御网**: L1 格式约束 (json_schema / json_object) + L2 业务契约深度校验 (Zod safeParse)
- **降级分支特异性**: `max_retries_exceeded`

---

##### 🔹 Round 1: {"urgency":99,"summary":""} -> ❌ 拦截: urgency<=5, summary min 5
##### 🔹 Round 2: {"urgency":88,"summary":"abc"} -> ❌ 拦截: urgency<=5, summary min 5
##### 🔹 Round 3: {"urgency":77,"summary":"xyz"} -> ❌ 拦截: urgency<=5, summary min 5

---
*系统平稳收敛,成功触发 L4 Never-Throw 优雅降级分支*
在前端画布与链路追踪界面中,可以看到节点并未红屏崩溃,而是清晰呈现了 3 轮尝试的轨迹与最终平稳捕获的降级状态:
4. 实测证据二:物理 Token 严重截断时的瞬时兜底
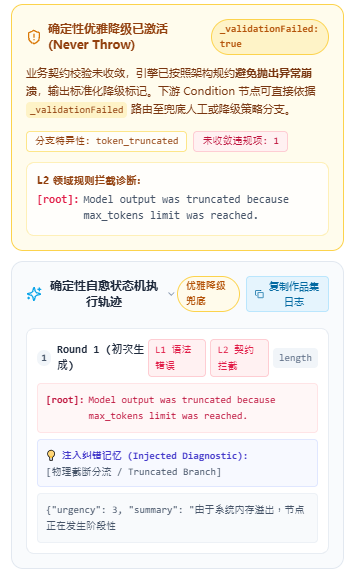
除了逻辑上的死循环,模型在现实中还会因为 max_tokens 设定过小而发生物理截断(只输出了半句 JSON 大括号未闭合)。以下为真实捕获的截断日志(截取自 测试日志及截图/输出被 max_tokens 截断.log):
### 🛡️ AI 工作流确定性结构化输出与自愈状态机复盘日志

- **执行结果**: ⚠️ 优雅降级兜底 (_validationFailed: true,未向外抛错)
- **总调用轮次**: 1 轮
- **降级分支特异性**: `token_truncated`
- **Finish Reason**: `length`
- **本轮原始输出**: {"urgency": 3, "summary": "由于系统内存溢出,节点正在发生阶段性
- **契约拦截明细**: [root]: Model output was truncated because max_tokens limit was reached.
面对物理截断,L4 兜底同样保障了引擎不抛异常、不阻塞下游,平滑进入降级处理通道:
五、给 Product Engineer 的工程思考
这次针对 Case #7 的翻车与回滚,是我们“边写边学”历程中极为宝贵的一笔财富。它打破了我们最初的技术傲慢:
- 警惕自作聪明的微小优化:为了节省少量 Token 而引入破坏模型语义整体性的复杂补丁,往往会引发更不可控的系统死锁;
- 接受不完美,掌控确定性:大模型本质是概率性的,再强大的模型也无法承诺绝对无错。消灭所有不确定性是不切实际的,更稳妥的工程解法是通过 L4 优雅降级,让上层业务在面对底层不确定性时,依然拥有确定性的容错轨道。
留白与引线:引擎虽然稳了,代码却变脏了?
当我们把 L1、L2、L3、L4 这套防线跑通后,代码评审(Code Review)中却暴露了一个极其致命的架构缺陷:
“为了测试这套工单场景,我们在引擎核心的
structured-output.ts里直接硬编码了工单的特定 Schema 和 130 多行测试用例!如果把这段引擎拿去做法律合同审查、或者做医疗质检工作流,难道还要去改引擎核心代码吗?”
这是典型的业务逻辑向系统引擎层下沉污染。
我们是如何进行架构清洗与业务彻底解耦的?又是如何通过严格的 42 样本麦克尼马尔(McNemar)统计检验,在数学上证明这套系统并非幸存者偏差的?
下一篇揭秘:《边写边学 AI 工作流引擎(四):架构纯度清洗与 42 样本统计检验复盘》。
关于作者
郭强 (GuoBug),Product Engineer,做平台工程也做业务增长。目前主要在折腾 AI 工作流编排、DAG 状态机与确定性系统架构。
开源项目与主页:https://github.com/GuoBug · https://guobug.github.io
欢迎就工作流引擎架构、拓扑调度和低门槛开发体验交流指教。